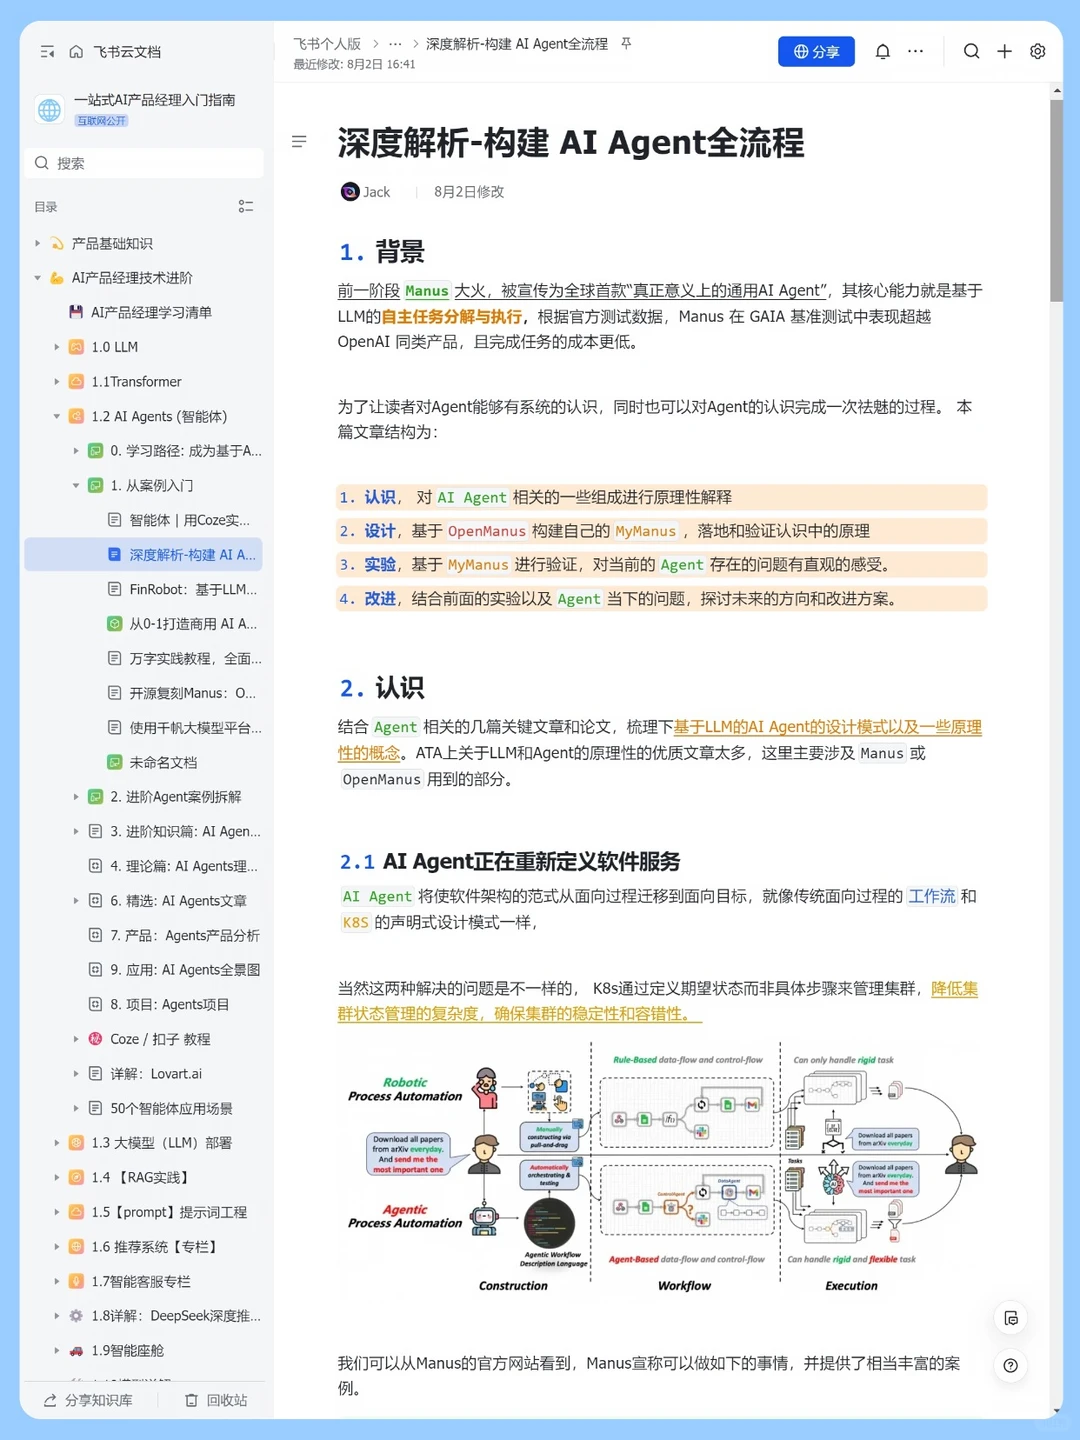
深度解析-构建 AI Agent全流程
从案例入门 · 认识、设计、实验、改进
1. 背景
参考图以 Manus 和 OpenManus 为切入点,讨论基于 LLM 的自主任务分解与执行。图中关于产品排名和成本的宣传性描述,没有附评测条件,本教程不把它作为已证实结论。
为了让读者对 Agent 能够有系统的认识,同时完成一次从认识到验证的过程,本篇文章结构为:
从原理走到实验
- 认识: 对 AI Agent 相关的一些组成进行原理性解释。
- 设计: 基于 OpenManus 构建自己的 MyManus,落地和验证认识中的原理。
- 实验: 基于 MyManus 进行验证,对当前 Agent 存在的问题有直观感受。
- 改进: 结合前面的实验以及 Agent 当下的问题,探讨未来的方向和改进方案。
2. 认识
2.1 AI Agent 正在重新定义软件服务
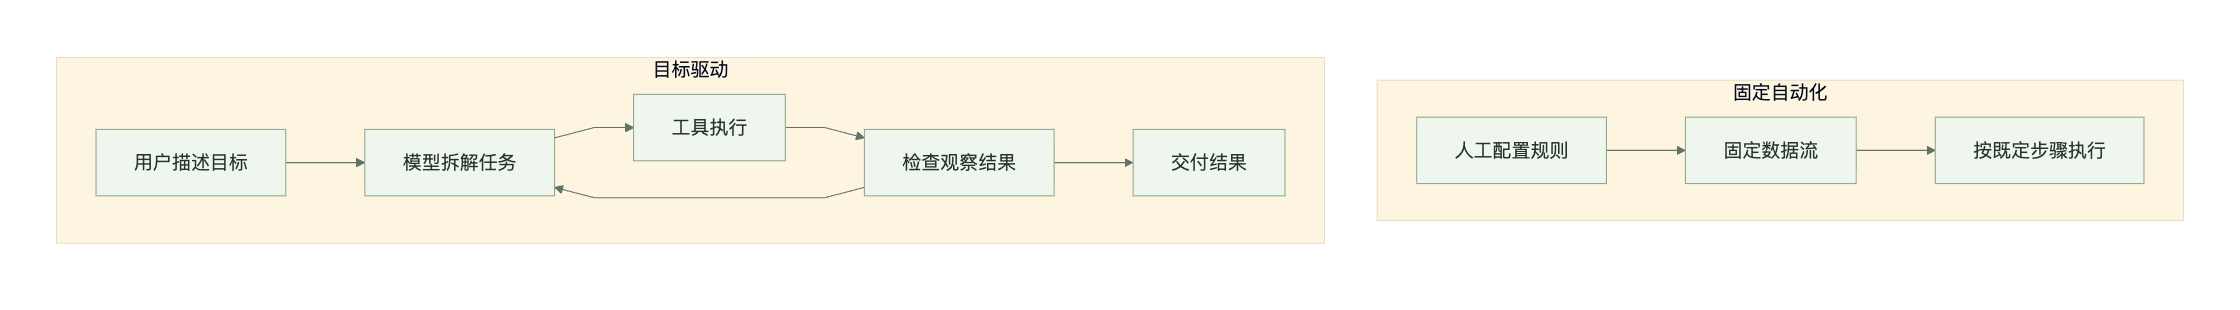
AI Agent 将软件架构的范式从面向过程迁移到面向目标,就像传统面向过程的工作流和 K8S 的声明式设计模式一样。这个比喻强调“描述希望得到的结果”,并不意味着二者具备相同的执行机制或可靠性。
K8S 通过定义期望状态而非具体步骤来管理集群,降低集群状态管理的复杂度。Agent 接收任务目标,根据可用工具和中间反馈选择下一步。
2.2 从目标到执行,需要哪些对象?
| 对象 | 保存什么 | 不应该混淆什么 |
|---|---|---|
| 任务 | 目标、限制、完成标准 | 目标不是详细执行脚本 |
| 计划 | 子任务与依赖 | 计划可以根据事实调整 |
| 工具 | 名称、参数、执行函数 | 模型声明调用不等于执行成功 |
| 状态 | 已完成步骤、结果、错误 | 不只保存完整聊天记录 |
| 终止规则 | 完成、失败、预算耗尽 | 不依赖模型无限自觉停止 |
3. 设计:构建自己的 MyManus
这里的 MyManus 是教学中的应用名字,不是 OpenManus 官方产品。先限制它只完成“读取三份本地资料,输出比较报告”这一项任务。
text
MyManus
├── planner        生成下一步操作
├── tools          读取允许目录、检索资料、写入结果
├── state          保存已读文件、证据与步骤状态
├── runner         执行工具并处理错误
└── evaluator 检查是否覆盖全部比较维度设计顺序: 先写验收标准,再写工具契约,然后建立状态记录,最后接模型。文件工具限制目录,输出报告单独存放。重复步骤达到上限时返回明确原因。
4. 实验:观察一条完整运行轨迹
| 实验 | 输入变化 | 应观察的结果 |
|---|---|---|
| 基准任务 | 三份资料齐全 | 三份均有引用,结论可回溯 |
| 缺少资料 | 删除其中一份测试资料 | 标明缺失,不编造内容 |
| 工具失败 | 读取工具返回超时 | 有界重试后给出失败原因 |
| 目标冲突 | 同时要求详细和不超过十字 | 追问或明确采用哪个限制 |
| 重复循环 | 工具一直返回相同内容 | 达到步骤上限后结束 |
记录每一步的工具、参数、结果摘要和耗时。面向用户展示任务状态和证据摘要即可,不需要要求模型公开内部思维链。
5. 改进:每次只改一个失败原因
资料不足就补检索与澄清;工具选择错误就改工具描述;重复查询就增加状态与去重;答案缺证据就建立引用校验;任务太长就拆分并保存检查点。
练习: 选一条失败轨迹,记录“失败位置 → 根因假设 → 修改 → 同样输入复测”。如果只展示成功输出,很难知道系统是否真的改好了。
项目参考:OpenManus 官方仓库。安装方式和依赖版本以仓库当前说明为准。
内容依据:用户提供的第 4 张参考图。保留其可见结构、概念和案例,截图未显示的步骤为教学补写。原图作者与历史标注见下方对照。
查看参考原图 · 完整保留截图中的图表与可见文字